特徴量ストア
機械学習の運用で、学習時と推論時で同じ特徴量の定義と計算を共有し、両者のずれ(training-serving skew)を防ぐための仕組みとして、最も適切なものを1つ選べ。
- A
特徴量ストア
- B
データ拡張
- C
ドロップアウト
- D
ハイパーパラメータ探索
正解と解説を見る
正解:A
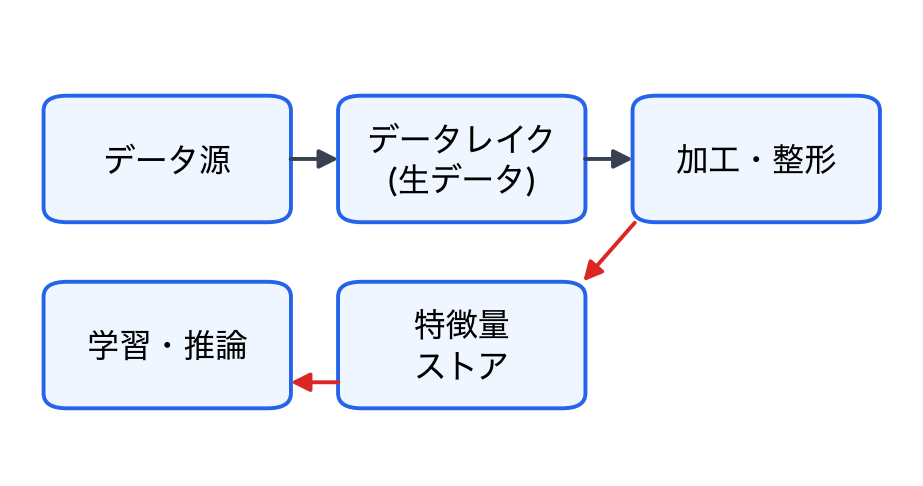
特徴量ストアは、特徴量を、定義・計算・保存して、学習と推論の両方で同じものを使えるようにする。モデルの精度低下の原因になる、前処理の食い違いを防ぐ。
- A
正しい。特徴量の再利用や、管理もしやすくなる。
- B
誤り。学習データを増やす手法。
- C
誤り。過学習を抑える手法。
- D
誤り。モデルの設定を探す作業。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。