視覚言語モデル
画像を理解して、文章で質問に答えられる視覚言語モデル(LLaVAなど)の典型的な構成として、最も適切なものを1つ選べ。
- A
画像を、音声に変換してから、言語モデルに入力する。
- B
言語モデルは使わず、画像を、色のヒストグラムだけで分類する。
- C
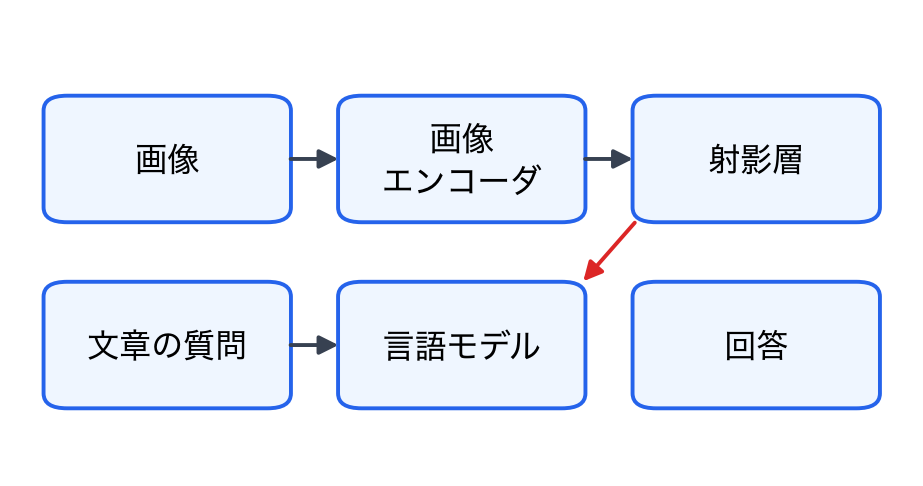
画像エンコーダで画像を特徴ベクトルにし、変換層(射影)で言語モデルの入力の形にして、言語モデルに入力する。
- D
画像と文章を、まったく別々に処理し、結果を連結しない。
正解と解説を見る
正解:C
視覚言語モデルは、画像エンコーダ(CLIPのViTなど)の出力を、変換層で言語モデルの埋め込みに合わせ、文章のトークンとあわせて、言語モデルに入力する。
- A
誤り。そのような構成ではない。
- B
誤り。言語モデルを使う。
- C
正しい。画像の特徴を、言語モデルが扱えるトークンのように入力する。
- D
誤り。結合して処理する。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。