Vision Transformerのパッチ分割
Vision Transformer(ViT)が画像を扱うときの入力の作り方として、最も適切なものを1つ選べ。
- A
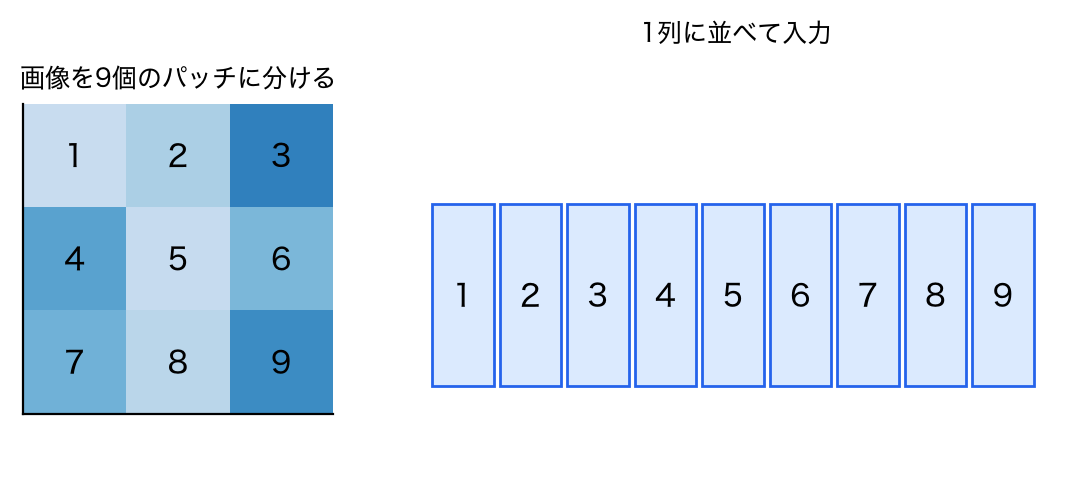
画像を小さな正方形のパッチに分け、それぞれをベクトルにして系列として入力する
- B
画像を1画素ずつ別々のモデルに入力する
- C
画像を音声に変換してから入力する
- D
画像を文章に変換してから入力する
正解と解説を見る
正解:A
ViTは画像をパッチに分けてベクトル化し、系列としてTransformerに入力する。大量のデータで学習すると高い精度を出す。
- A
正しい。パッチを単語のように扱い、位置情報を加えてTransformerに入力する。
- B
誤り。計算量が非常に大きくなる。
- C
誤り。そのような変換は行わない。
- D
誤り。画像のパッチを直接ベクトルにする。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。