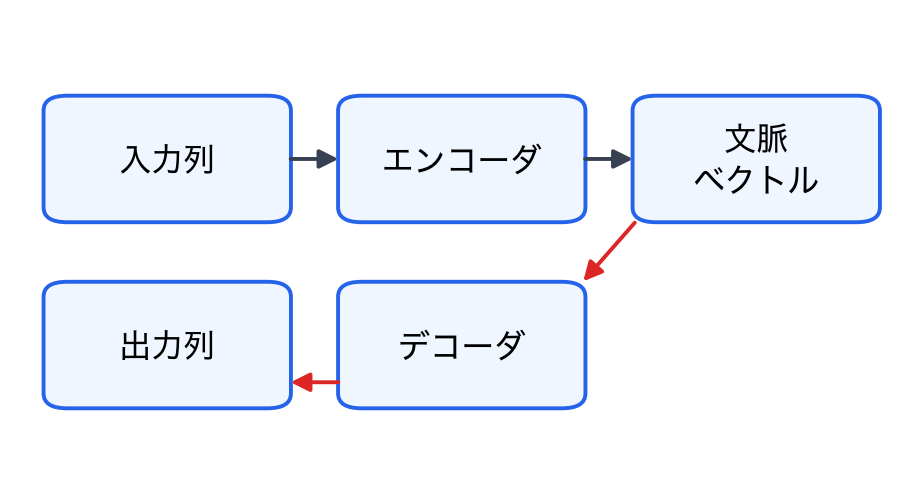
Seq2Seqの固定長ベクトル
エンコーダの最後の隠れ状態だけをデコーダに渡す初期のSeq2Seqの課題と、その解決のために導入された仕組みの組み合わせとして、最も適切なものを1つ選べ。
- A
固定長ベクトルが大きすぎることが課題で、Dropoutで解決した
- B
長い文章の情報を1つの固定長ベクトルに押し込む限界があり、Attentionで解決した
- C
出力の語彙が少ないことが課題で、GANで解決した
- D
学習データが多すぎることが課題で、データ拡張で解決した
正解と解説を見る
正解:B
固定長ベクトルでは長い入力の情報が失われやすい。Attentionで、デコーダが入力の必要な部分に注目できるようになった。
- A
誤り。Dropoutは過学習を抑える手法で、この課題の解決策ではない。
- B
正しい。デコーダが入力の各位置に注目できるようになり、長い文章でも精度が向上した。
- C
誤り。GANは生成モデルの枠組みで、この課題と関係がない。
- D
誤り。データ拡張はデータを増やす手法。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。