正解率の落とし穴
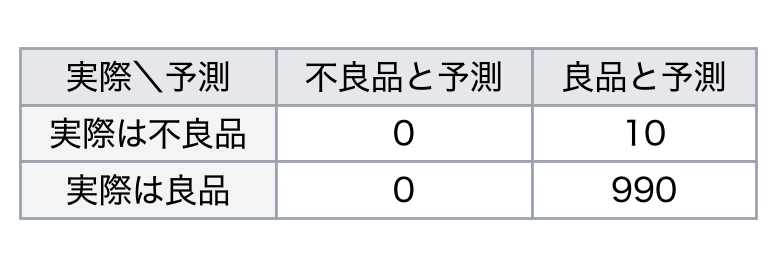
ある工場で、製品の不良品検査にAIを導入した。1,000個の製品に対する検査結果を、図の混同行列に示す(陽性=不良品)。このモデルの評価として、最も適切なものを1つ選べ。
- A
正解率が99%なので、非常に優れたモデルである
- B
不良品の割合が低いため、AIによる検査は意味がない
- C
正解率を100%にするために、学習データを増やせば必ず解決する
- D
正解率は高いが、不良品を1つも見つけられないため、再現率など別の指標でも評価すべきである
正解と解説を見る
正解:D
クラスの偏りが大きい場合、正解率は性能を表さない。再現率・適合率・F値・PR曲線などを使い、目的に合った指標を選ぶ。
| 実際\予測 | 陽性と予測 | 陰性と予測 |
|---|---|---|
| 実際は陽性 | TP(真陽性) | FN(偽陰性) |
| 実際は陰性 | FP(偽陽性) | TN(真陰性) |
- A
誤り。不良品の検出という目的を果たしていない。
- B
誤り。指標を選び直せば、有用なモデルを作れる可能性がある。
- C
誤り。評価指標の選び方の問題で、データ量の問題ではない。
- D
正しい。クラスの偏りが大きいデータでは、正解率だけでは性能が分からない。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。