VQA
画像と、その画像についての質問文(「この写真に写っている犬は何匹?」など)を入力して、答えを出力するタスクを何というか。最も適切なものを1つ選べ。
- A
物体検出
- B
音声認識
- C
VQA(視覚的質問応答、Visual Question Answering)
- D
機械翻訳
正解と解説を見る
正解:C
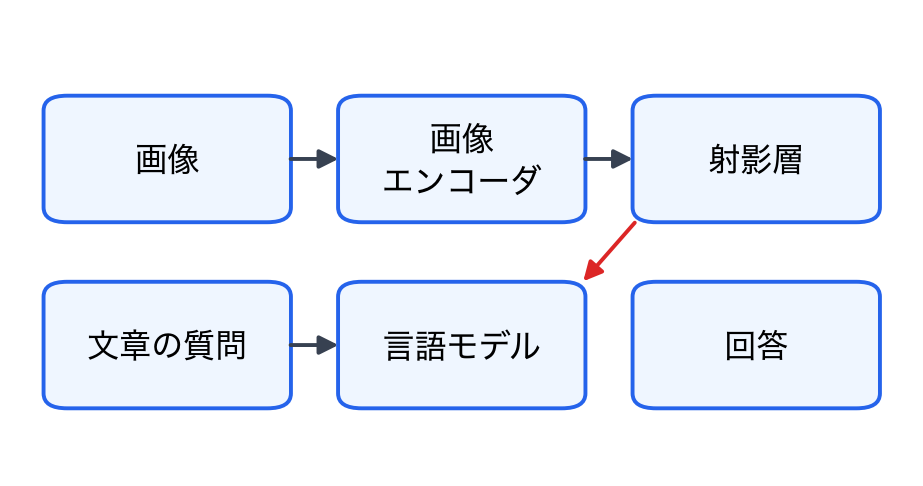
VQA は、画像とその画像についての質問から答えを出力するマルチモーダルなタスク。
- A
誤り。物体の位置とクラスを求めるタスク。
- B
誤り。音声を文字に変換するタスク。
- C
正しい。画像と言語の両方を理解する必要がある、マルチモーダルなタスクの代表例。
- D
誤り。ある言語の文章を別の言語に変換するタスク。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。