Chain-of-Thought
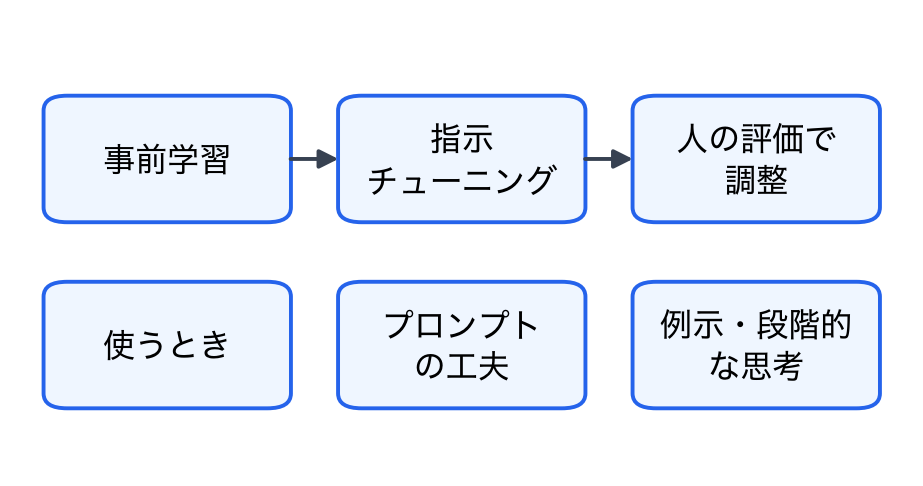
大規模言語モデルに、答えだけでなく途中の考え方を順を追って書かせる(または、そのような例を示す)ことで、計算や推論が必要な問題の正答率を高めるプロンプトの工夫を何というか。最も適切なものを1つ選べ。
- A
プロンプトインジェクション
- B
Chain-of-Thought(思考の連鎖)
- C
ドロップアウト
- D
アノテーション
正解と解説を見る
正解:B
Chain-of-Thought は、途中の考え方を書かせて推論の正答率を高めるプロンプトの工夫。
- A
誤り。悪意のある指示を紛れ込ませる攻撃。
- B
正しい。「順を追って考えてください」と指示するだけでも効果があることが知られている。
- C
誤り。過学習を抑える手法。
- D
誤り。学習データに正解の情報を付ける作業。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。