LoRA
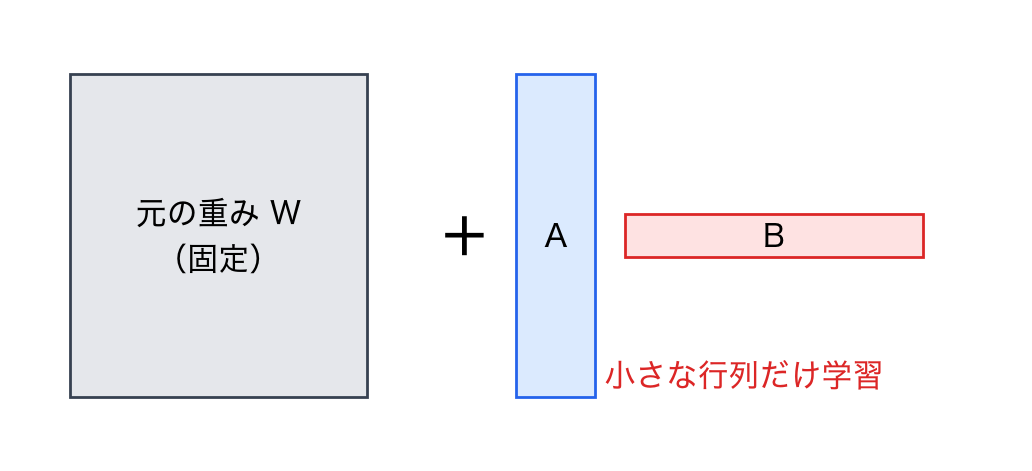
大規模なモデルをファインチューニングするとき、元の重みは固定したまま、小さな低ランクの行列だけを追加で学習して、必要な計算資源を大きく減らす手法として、最も適切なものを1つ選べ。
- A
ドロップアウト
- B
LoRA(Low-Rank Adaptation)
- C
データ拡張
- D
知識の蒸留
正解と解説を見る
正解:B
LoRA は、元の重みを固定し、低ランクの行列だけを学習する効率的なファインチューニングの手法。
- A
誤り。過学習を抑える手法。
- B
正しい。学習するパラメータが少ないため、少ない GPU のメモリでも大規模なモデルを調整できる。
- C
誤り。学習データを増やす手法。
- D
誤り。大きなモデルの出力を手本に、小さなモデルを学習させる手法。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。