Vision Transformer
Vision Transformer(ViT)の説明として、最も適切なものを1つ選べ。
- A
畳み込み層だけで画像を処理する。
- B
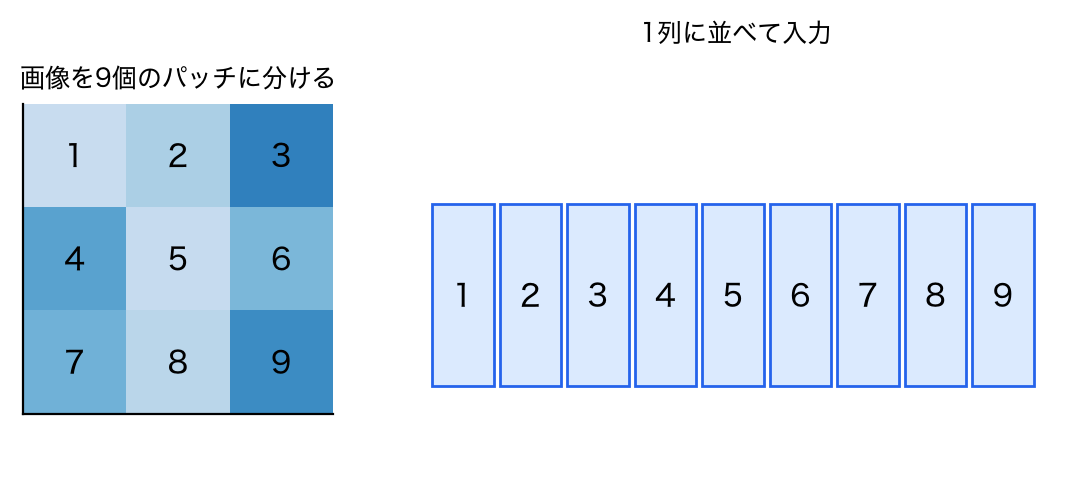
画像を小さなパッチに分け、各パッチを単語のように扱って Transformer で処理する。
- C
音声の波形を直接生成する。
- D
文章を画像に変換する専用のモデルである。
正解と解説を見る
正解:B
ViT は、画像をパッチに分けて Transformer で処理する画像認識のモデル。
- A
誤り。ViT の中心は Transformer で、畳み込みを主に使うモデルではない。
- B
正しい。大量のデータで事前学習すると、CNN に並ぶか上回る精度が出ることが示された。
- C
誤り。これは WaveNet などの説明。
- D
誤り。ViT は主に画像の分類などに使われる。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。