CLIP
大量の画像とその説明文の組を使い、画像とテキストを同じ空間のベクトルに対応させるように学習したモデルとして、最も適切なものを1つ選べ。
- A
CLIP
- B
ResNet
- C
WaveNet
- D
word2vec
正解と解説を見る
正解:A
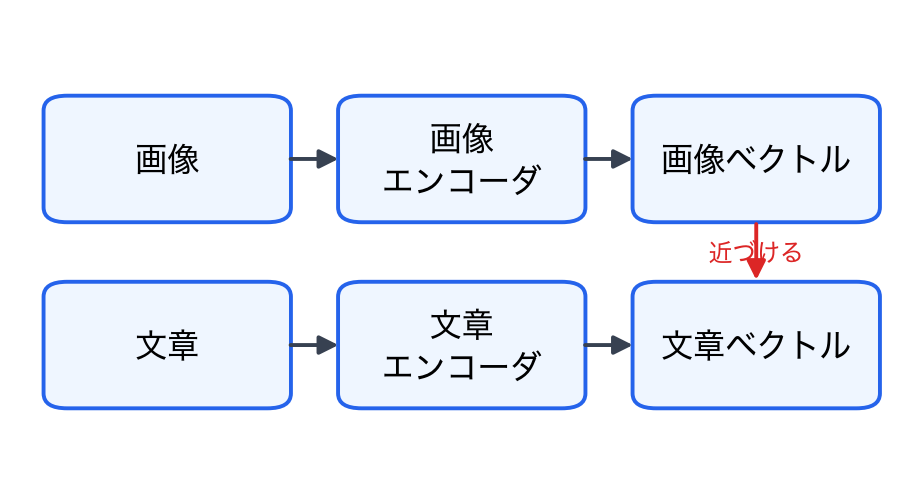
CLIP は、画像とテキストを同じ空間に対応させる対照学習のモデル。
- A
正しい。対応する画像とテキストのベクトルが近く、対応しない組が遠くなるように学習する(対照学習)。追加の学習なしで、画像の分類などに使える。
- B
誤り。画像だけを扱う CNN のモデル。
- C
誤り。音声の波形を生成するモデル。
- D
誤り。テキストだけを扱い、単語の分散表現を学習する手法。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。