AlphaGo Zero
人間の棋譜を一切使わず、自分自身との対局(自己対局)だけで学習して、それまでの AlphaGo を上回る強さになった囲碁プログラムとして、最も適切なものを1つ選べ。
- A
AlphaGo
- B
AlphaStar
- C
AlphaGo Zero
- D
OpenAI Five
正解と解説を見る
正解:C
AlphaGo Zero は、人間の棋譜を使わず自己対局だけで学習した囲碁プログラム。
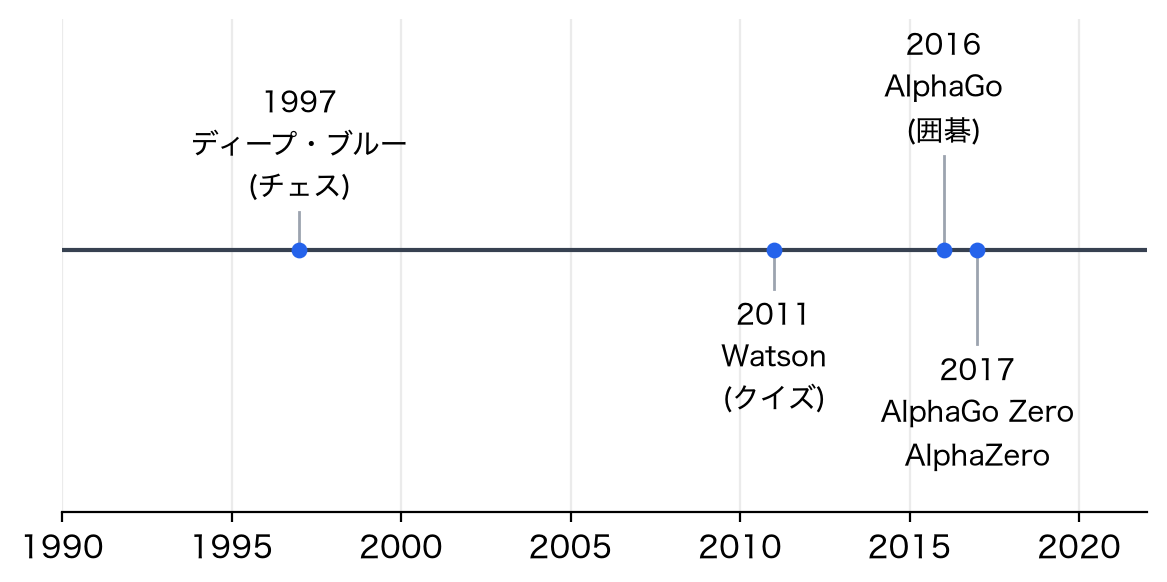
- A
誤り。最初の AlphaGo は、人間の棋譜による教師あり学習のあとに、自己対局による強化学習を行った。
- B
誤り。リアルタイム戦略ゲーム「StarCraft II」で高い成績を出したプログラム。
- C
正しい。その後、囲碁以外のゲームにも対応した AlphaZero が作られた。
- D
誤り。対戦ゲーム「Dota 2」で人間のチームに勝ったプログラム。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。