RLHF
大規模言語モデルの出力を、人間が評価した結果をもとに強化学習で調整し、人間の意図や好みに合った応答をするようにする手法として、最も適切なものを1つ選べ。
- A
RLHF(人間のフィードバックによる強化学習)
- B
Masked Language Model
- C
Teacher Forcing
- D
Word2vec
正解と解説を見る
正解:A
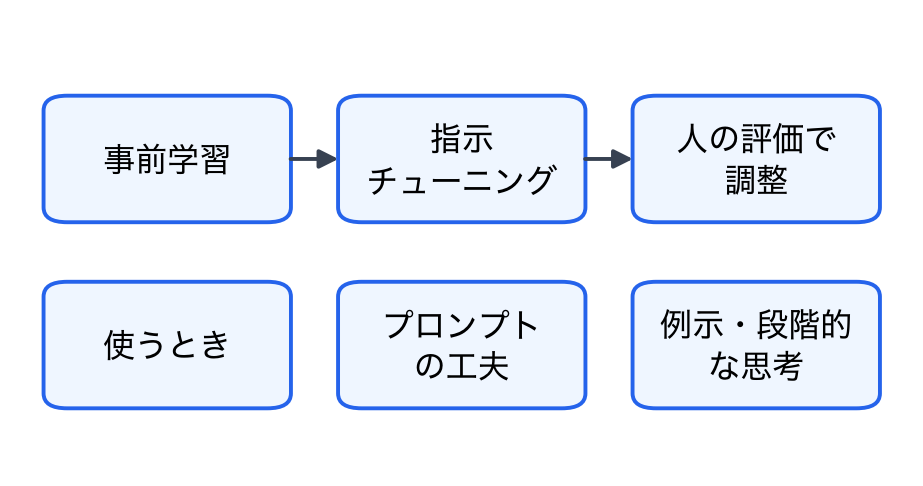
RLHF は、人間の評価をもとに強化学習で言語モデルの出力を調整する手法。
- A
正しい。人間の評価から報酬モデルを作り、その報酬を最大にするように言語モデルを調整する。
- B
誤り。文中の一部の単語を隠して当てる事前学習のタスク。
- C
誤り。系列を生成するモデルの学習で、正解を次の入力に使う方法。
- D
誤り。単語の分散表現を学習する手法。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。