Few-shot学習
大規模言語モデルに、モデルの重みを更新せず、指示とともに少しの例をプロンプトに示すだけで、新しいタスクをこなさせる方法として、最も適切なものを1つ選べ。
- A
ファインチューニング
- B
蒸留
- C
Few-shot 学習(インコンテキスト学習)
- D
データ拡張
正解と解説を見る
正解:C
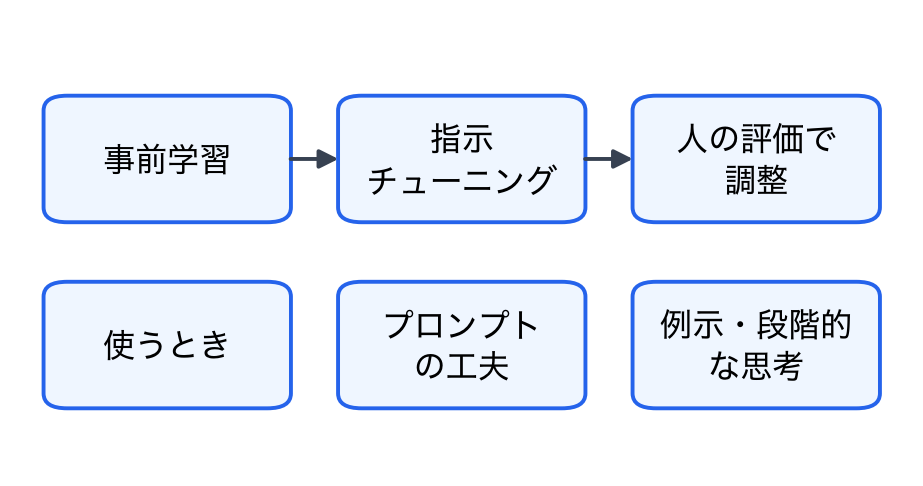
Few-shot 学習は、プロンプトに少しの例を示すだけで、重みを更新せずにタスクをこなさせる方法。
- A
誤り。追加のデータでモデルの重みを更新する方法。
- B
誤り。大きなモデルの出力を手本に、小さなモデルを学習させる方法。
- C
正しい。例を示さずに指示だけで解かせる場合は Zero-shot と呼ぶ。GPT-3 でこの能力が広く知られるようになった。
- D
誤り。学習データを加工して増やす方法。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。