ε-greedy方策
強化学習で、一定の確率 ε でランダムに行動を選び、それ以外は今わかっている中で価値が最も高い行動を選ぶ方策として、最も適切なものを1つ選べ。
- A
UCB方策
- B
ε-greedy方策
- C
Q学習
- D
方策勾配法
正解と解説を見る
正解:B
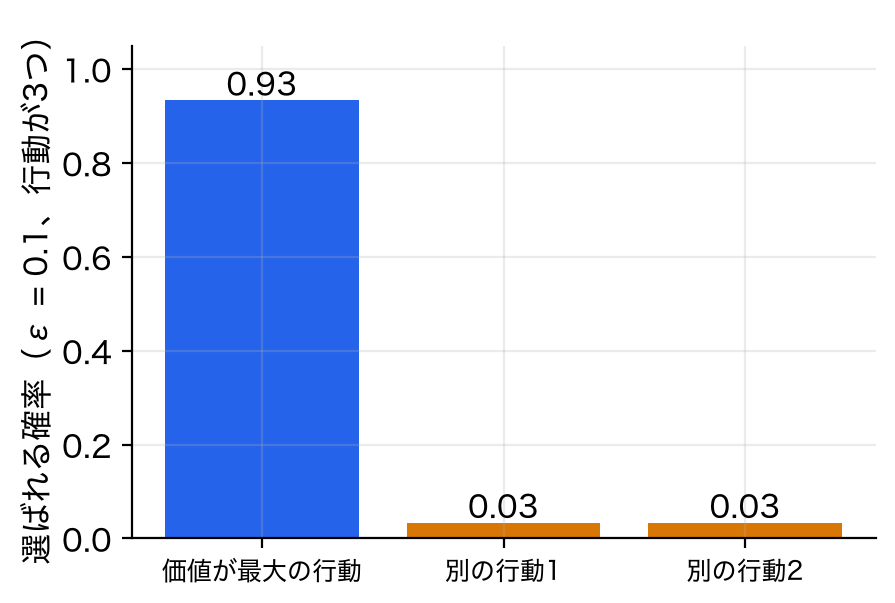
ε-greedy方策は、確率 ε でランダムな行動を試し、それ以外は最善の行動を選ぶ方策。
- A
誤り。UCB方策は、試した回数が少ない行動ほど優先して選ぶように、価値の見積もりに上乗せをする方策。
- B
正しい。未知の行動を試す「探索」と、よい行動を使う「活用」のバランスをとるための代表的な方法。
- C
誤り。Q学習は行動の価値(Q値)を更新していく学習方法で、行動の選び方そのものではない。
- D
誤り。方策をパラメータで表し、その勾配を使って直接最適化する手法。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。