ランダムフォレスト
ランダムフォレストの説明として、最も適切なものを1つ選べ。
- A
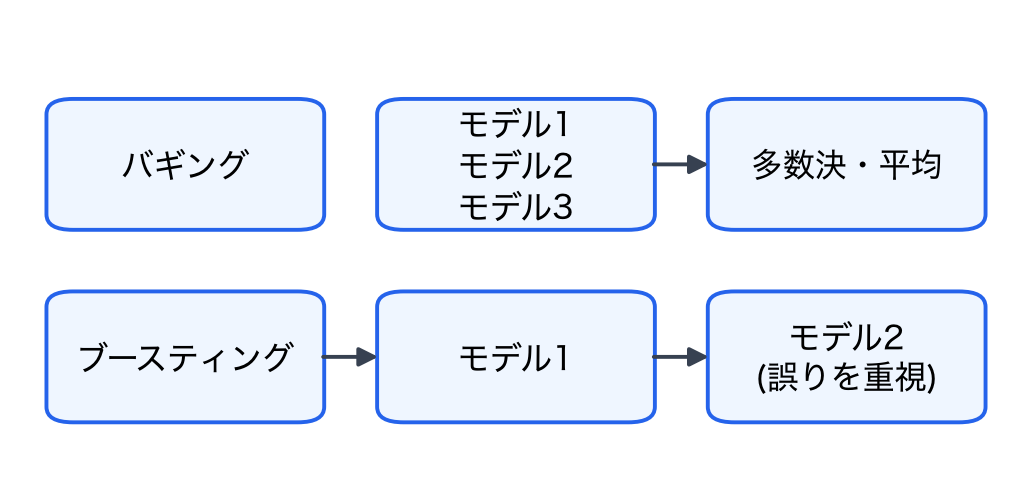
前のモデルが間違えたデータを重視しながら、決定木を1つずつ順番に学習していく。
- B
予測したいデータに近い k 個のデータの多数決で予測する。
- C
データと特徴量をランダムに選んで多数の決定木を作り、その多数決や平均で予測する。
- D
クラス間のマージンが最大になるような境界を求める。
正解と解説を見る
正解:C
ランダムフォレストは、ランダムに選んだデータと特徴量で多数の決定木を作り、結果をまとめる手法。
- A
誤り。これは勾配ブースティングなど、ブースティングの考え方。
- B
誤り。これは k 近傍法の説明。
- C
正しい。バギングの一種で、決定木1本より過学習しにくい。
- D
誤り。これはサポートベクターマシンの説明。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。