RAGの仕組み
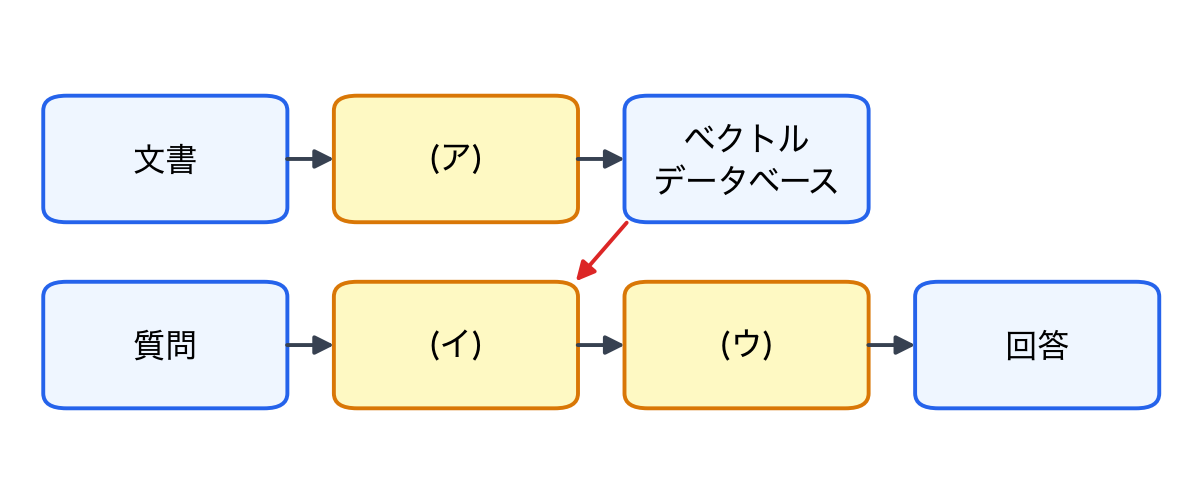
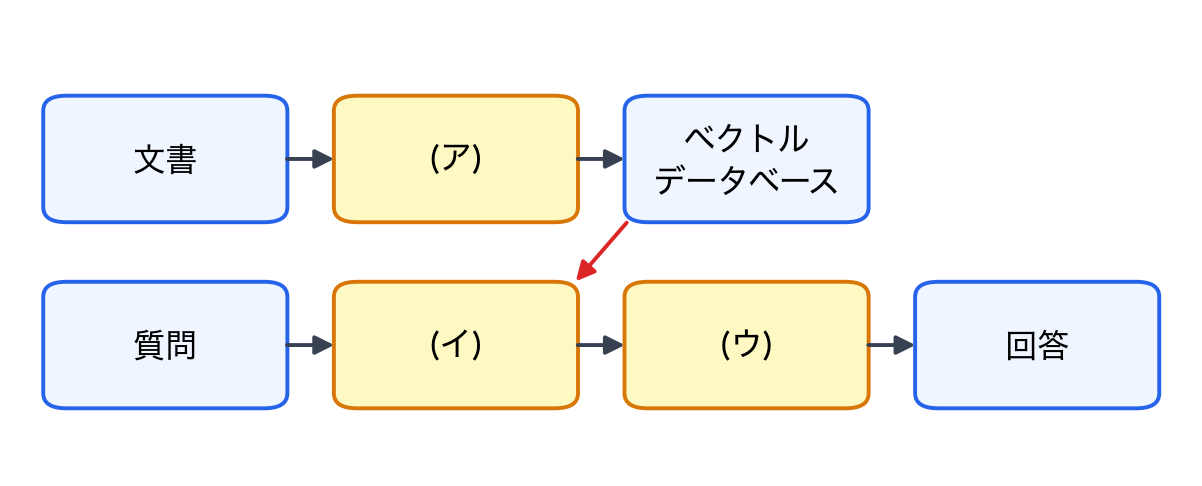
図はRAG(検索拡張生成)の処理の流れで、(ア)〜(ウ)は処理を表す。(ア)〜(ウ)に当てはまる処理を含む、RAGの基本的な流れとして、最も適切なものを1つ選べ。
- A
文書を分割して保存しておき、質問と同じ単語を含む文書を、一致する単語の数で選んで渡す。
- B
質問を受けたら先にLLMに回答を作らせ、その回答に近い文書を探して出典として添える。
- C
文書をLLMに要約させて保存しておき、質問を受けたら、要約の全体をプロンプトに入れる。
- D
文書を分割してベクトル化して保存し、質問に意味の近い文書を検索してLLMに渡す。
正解と解説を見る
正解:D
RAGは、事前に文書をチャンクに分割し、埋め込み(ベクトル)にして保存する。質問時に、近い文書を検索し、プロンプトに加えて生成する。
- A
誤り。キーワード検索の説明。ベクトル検索は、単語が一致しなくても、意味の近い文書を探せる。
- B
誤り。検索は回答を作る前に行い、取り出した文書を根拠として生成する。
- C
誤り。検索をせずに全体を渡すと、コンテキストの上限に達しやすい。RAGは、質問に関係する部分を検索して渡す。
- D
正しい。意味の近さで検索する(セマンティック検索)。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。