RLHF
RLHF(人間のフィードバックによる強化学習)の説明として、最も適切なものを1つ選べ。
- A
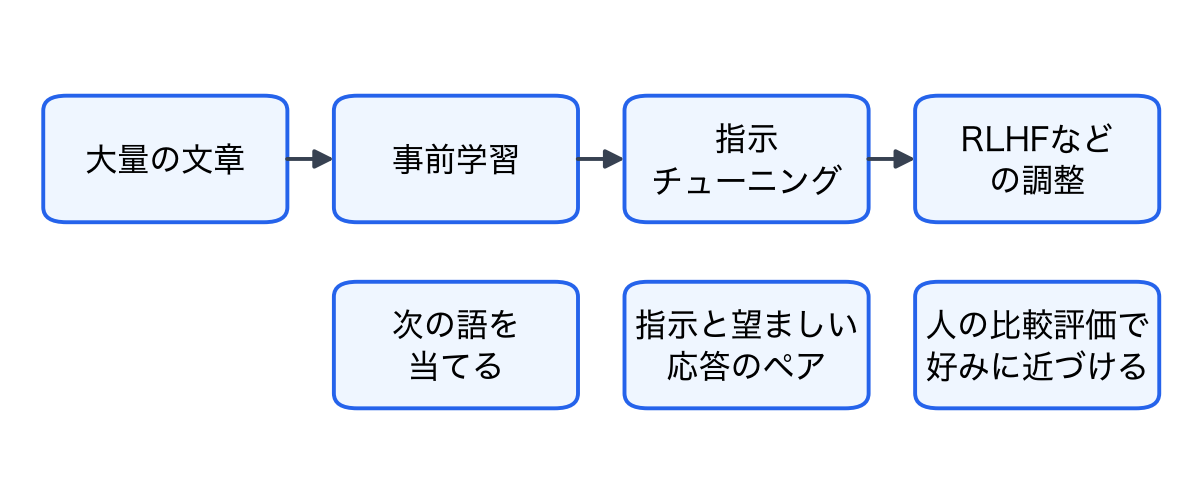
人が複数の回答を比べて評価し、その評価をもとに好まれる回答を出すよう調整する。
- B
人が作った指示と模範解答のペアを大量に用意し、それをそのまま学習させて調整する。
- C
モデル自身が回答を作って採点し、人の評価を使わずに強化学習で調整する。
- D
検索で取り出した文書をプロンプトに加え、根拠のある回答を出させる。
正解と解説を見る
正解:A
RLHFは、人の評価から報酬モデルを作り、その報酬が高くなるように、モデルを強化学習で調整する。より有用で安全な応答を出させる狙いがある。
- A
正しい。有用さや安全性を高めるために使われる。
- B
誤り。指示チューニング(教師ありファインチューニング)の説明。
- C
誤り。人の評価を使うのがRLHF。AIの評価を使う手法は、RLAIFなどと呼ばれる。
- D
誤り。RAG(検索拡張生成)の説明で、モデルの調整ではない。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。