指示チューニング
事前学習したモデルに、「指示」と「望ましい応答」のペアを学習させ、人の指示に従って答えられるようにする追加の学習として、最も適切なものを1つ選べ。
- A
事前学習(プレトレーニング)
- B
知識蒸留
- C
指示チューニング
- D
RLHF
正解と解説を見る
正解:C
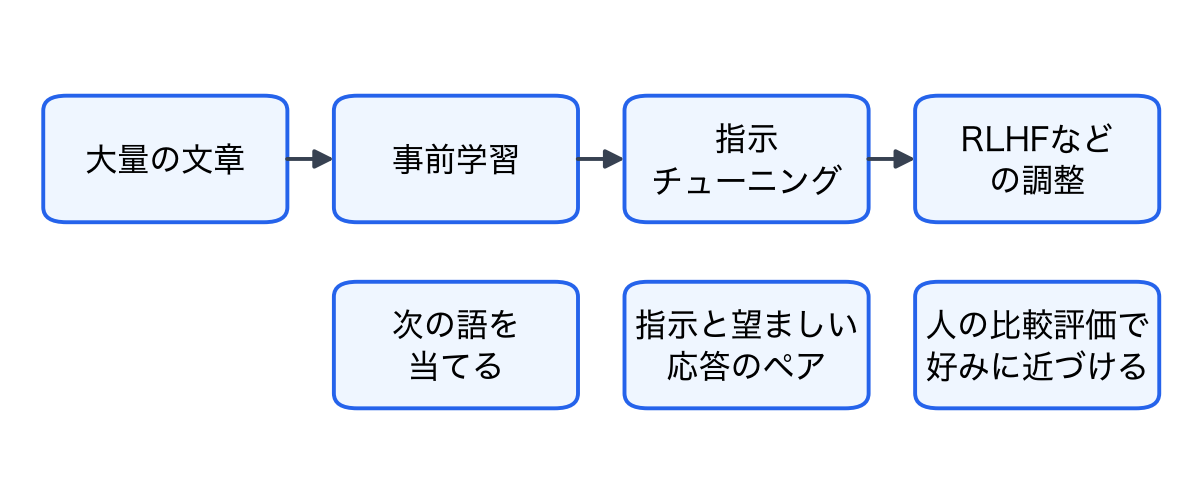
指示チューニングは、指示と応答のペアで追加学習する。事前学習だけだと、文章の続きは書けても、指示に従う振る舞いにはなりにくい。
- A
誤り。大量の文章で次のトークンを予測する、最初の学習段階。
- B
誤り。大きなモデルの出力を手本にして、小さなモデルを学習させる手法。
- C
正しい。指示チューニング(Instruction Tuning)は、ファインチューニングの一種。
- D
誤り。人が回答を比べた評価をもとに調整する手法。指示と応答のペアで学習させるのは、指示チューニング。
このサイトの問題は、各試験の公開されているシラバスに沿って作ったオリジナルの模擬問題です。本試験の問題ではありません。日本ディープラーニング協会(JDLA)・一般社団法人生成AI活用普及協会(GUGA)の公式サービスではありません。